


SEO programmatique : faut-il vraiment publier des milliers de pages ?
SEO programmatique : faut-il vraiment publier des milliers de pages ?
Réponse directe
Publier beaucoup de pages n’est pas une faute en soi. Publier beaucoup de variantes dont seul le nom d’une ville, d’un produit ou d’une technologie change peut en devenir une.
Le SEO programmatique consiste à produire des pages à partir d’un gabarit et de données structurées. Cette méthode peut être pertinente pour un catalogue riche, un comparateur, plusieurs implantations ou une base de compatibilités. Elle devient fragile lorsque l’automatisation précède la question essentielle : chaque famille de pages apporte-t-elle une réponse distincte et vérifiable ?
Google ne donne aucun nombre maximal de pages et ne présente pas toute automatisation comme du spam. Ses règles visent le contenu produit à grande échelle lorsqu’il sert principalement à manipuler le classement et apporte peu ou pas de valeur à l’utilisateur. Le risque ne se lit donc pas dans le compteur de pages. Il se lit dans leur raison d’exister.
Un avertissement, pas l’annonce d’une nouvelle pénalité
Le 7 septembre 2026, Search Engine Roundtable a reproduit une réponse de John Mueller publiée sur Bluesky. Il réagissait à un site construit à partir de nombreuses combinaisons de domaines, de technologies et d’attributs.
Son constat est simple : il est facile de générer de nombreuses pages, encore plus avec des générateurs de code. Il est beaucoup plus difficile d’apporter une valeur réelle à l’utilisateur. Des pages peuvent avoir chacune « un peu » de valeur tout en formant, dans leur ensemble, un site peu convaincant.
Cette réponse ne crée pas une nouvelle règle et ne permet pas de prédire une sanction automatique. John Mueller parle d’un cas particulier et indique que rétablir la perception de valeur peut demander du temps et un effort important. Les politiques officielles de Google restent la référence : la technologie employée n’est pas le critère principal. L’intention et l’utilité du contenu le sont.
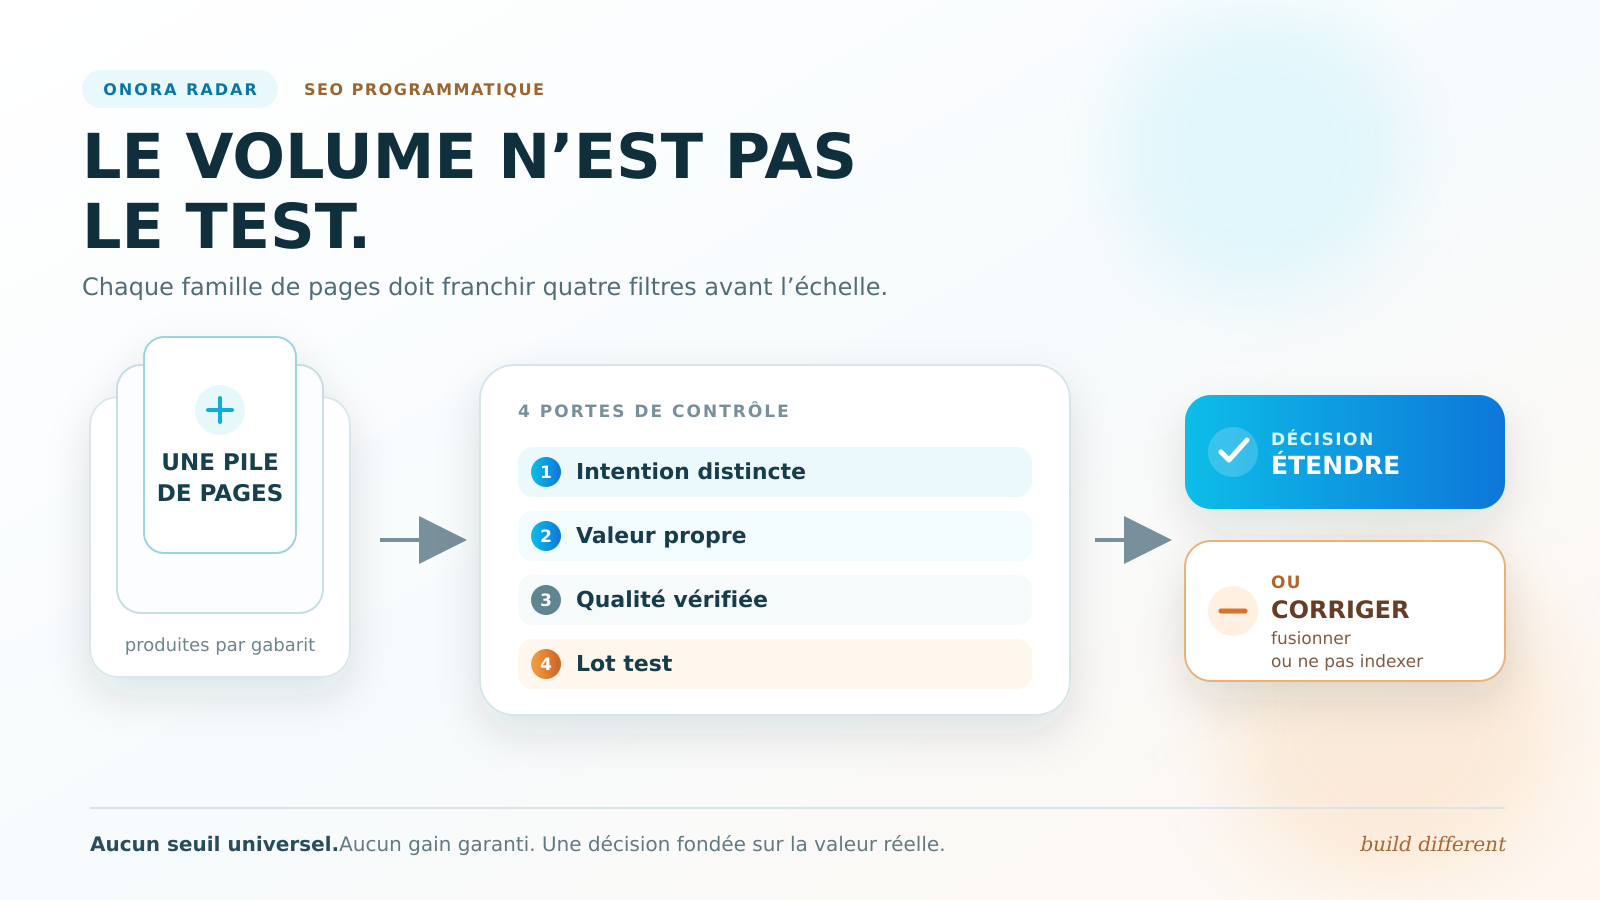
Avant de déployer un système programmatique, quatre filtres permettent de séparer une vraie architecture éditoriale d’une usine à variantes.
Filtre 1 : l’intention est-elle réellement distincte ?
Une page supplémentaire doit répondre à une question que la page principale ne traite pas correctement.
Pour un catalogue, une page peut être justifiée si une référence possède des caractéristiques, des compatibilités, une disponibilité ou un usage propres. Pour une entreprise locale, une page territoriale peut être utile si la zone modifie les délais, l’équipe, les modalités d’intervention ou les preuves disponibles. Pour un logiciel, une page de comparaison peut exister si elle documente des différences vérifiées et aide vraiment à choisir.
À l’inverse, remplacer « Nantes » par « Bordeaux » dans le titre et deux paragraphes ne crée pas une nouvelle intention. Le même problème apparaît avec des pages combinant automatiquement un métier, un outil et une ville sans information spécifique.
Le premier contrôle consiste donc à regrouper les pages par famille et à formuler la question précise à laquelle chacune doit répondre. Si plusieurs familles aboutissent à la même réponse, elles doivent probablement être fusionnées avant toute génération.
Filtre 2 : quelle valeur propre chaque page peut-elle prouver ?
Un gabarit organise l’information. Il ne fabrique pas la matière.
La valeur propre peut venir d’une donnée produit, d’un stock, d’une disponibilité, d’une compatibilité testée, d’une implantation réelle, d’une réglementation locale, d’une expérience documentée ou d’une comparaison fondée sur des critères vérifiables.
Une simple reformulation n’est pas une preuve. Une introduction différente écrite par une IA ne compense pas l’absence de donnée spécifique. Ajouter une longue définition générique à chaque variante ne rend pas davantage la page utile.
Avant de coder le générateur, il faut donc identifier la source de vérité de chaque champ : catalogue, ERP, documentation technique, équipe locale, tests ou base interne maintenue. Il faut aussi prévoir ce qui se passe lorsque la donnée manque. Une page qui remplit un vide avec une phrase plausible devient rapidement impossible à défendre et à maintenir.
Filtre 3 : la qualité est-elle contrôlée dans son ensemble ?
Le contenu principal n’est qu’une partie du système. Les titres, descriptions, données structurées, liens internes, images, URL et règles d’indexation doivent rester cohérents.
Un générateur peut produire un texte correct tout en créant des milliers de titres identiques, des liens vers des pages sans intérêt ou un balisage structuré qui ne correspond pas au contenu visible. Il peut également transformer une erreur présente dans la base source en erreur répétée sur tout le site.
Google rappelle dans son guide consacré aux fonctionnalités de recherche générative que les fondamentaux du SEO restent valables. Il recommande un contenu original, utile et non générique, ainsi qu’une structure technique claire. Il précise aussi qu’une grande quantité de pages ne rend pas un site plus qualitatif ni plus pertinent.
Le contrôle doit donc porter sur une page individuelle, mais aussi sur une famille complète et sur ses relations avec le reste du site.
Filtre 4 : peut-on commencer par un lot test ?
La meilleure protection contre une mauvaise idée déployée à grande échelle reste de ne pas commencer à grande échelle.
Choisissez un lot limité et cohérent, sans chercher un nombre présenté comme universel. Publiez-le avec les mêmes données, gabarits et règles techniques que le futur dispositif. Vérifiez ensuite ce que Google explore et indexe, les requêtes réellement obtenues dans Search Console et la manière dont les visiteurs utilisent ces pages.
Le lot test doit conduire à une décision explicite :
- étendre, si les pages répondent à des intentions distinctes et attirent des visites pertinentes ;
- corriger, si la donnée, le gabarit ou le maillage limitent leur utilité ;
- fusionner ou ne pas indexer, si plusieurs pages se concurrencent ou n’apportent aucune réponse propre.
Il n’existe pas de seuil garanti d’impressions, de délai universel d’indexation ni de taux de conversion valable pour tous les sites. Les critères doivent être définis selon le marché, le volume de recherche disponible et l’objectif commercial réel.
La fiche de décision avant d’automatiser
Une TPE ou une PME peut cadrer son projet sur une seule page avant de lancer le développement :
- Famille de pages visée : produits, villes, usages, comparaisons ou compatibilités.
- Intention distincte : la question précise traitée par cette famille.
- Valeur propriétaire : la donnée, la preuve ou l’expérience absente du gabarit générique.
- Source et responsable : l’endroit où la donnée est maintenue et la personne qui la contrôle.
- Règles de qualité : contenu, métadonnées, balisage, liens internes et gestion des données manquantes.
- Lot test et décision : ce qui sera observé avant d’étendre, de corriger ou d’arrêter.
Cette fiche déplace la conversation. On ne demande plus combien de pages l’outil peut générer. On demande combien de pages l’entreprise peut réellement justifier, vérifier et maintenir.
Le SEO programmatique peut être un levier puissant. Mais l’échelle ne transforme pas une page faible en actif commercial. Elle ne fait qu’en multiplier les conséquences.
Sources
- John Mueller, réponse sur le SEO programmatique publiée sur Bluesky
- Search Engine Roundtable, transcription et contexte de la réponse, 7 septembre 2026
- Google Search Central, règles concernant le contenu produit à grande échelle, mise à jour du 28 août 2026
- Google Search Central, guide pour les fonctionnalités de recherche générative, mise à jour du 10 juillet 2026
